DESCOBERTA DE MODELOS DE IA
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Escolha uma API de Imagem para Vídeo que combine com sua imagem
PROVEDORES
 Black Forest Labs
 Grok
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI


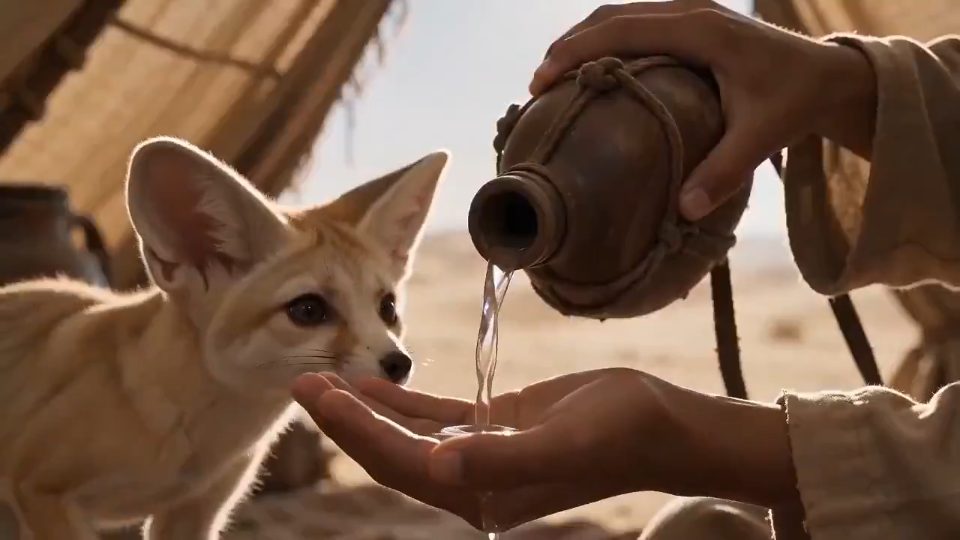


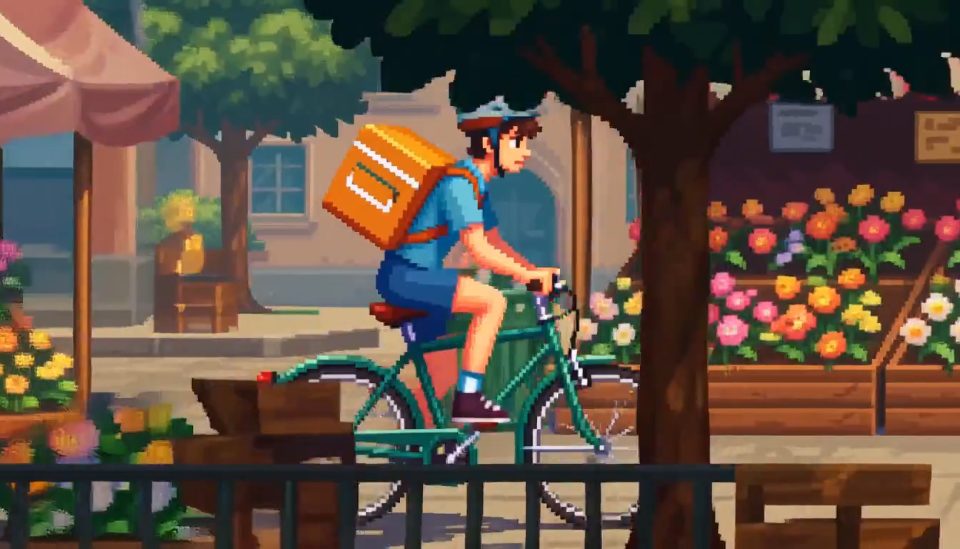




Cronologia de lançamento dos modelos
Vidu Q4
ViduVidu Q4 preview video generation with image or multi-reference guidance, audio, up to 16 seconds, and up to 4K output.
MiniMax H3 Max 16-bit Pixel
MiniMaxGere vídeos em pixel art de 16 bits com áudio em 768P, de 5 a 15 segundos, a partir de texto ou de uma imagem inicial.
Wan 3.0 Prime
AlibabaGeração de vídeo Alibaba Wan 3.0 Prime com referências de texto, imagem, vídeo, áudio, documento e página web.
Wan 3.0
AlibabaGeração de vídeo Alibaba Wan 3.0 com referências de texto, imagem, vídeo, áudio, documento e página web.
MiniMax H3 Max Turbo
MiniMaxGere vídeos de 5 a 15 segundos a partir de texto ou imagens em 480P, 768P ou 1080P.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceModelo de vídeo de nova geração da ByteDance para narrativas longas, com até 50 referências multimodais
MiniMax H3
MiniMaxGeração de vídeo multimodal com áudio nativo do MiniMax H3 (Hailuo 03), com saída de até 2K.
Seedance 2.0 Mini
ByteDanceModelo de vídeo Seedance 2.0 econômico da ByteDance para geração mais rápida e menor custo de inferência
Seedance 2.0 Fast
ByteDanceVídeo multimodal rápido e acessível com entradas de texto, imagem, vídeo e áudio até 720p
Dê à imagem aprovada uma próxima ação clara
Uma API de imagem para vídeo parte de informação visual que você já possui. Escolha um modelo adequado ao ativo e consulte a documentação para planejar movimento e saída, preservando o que deve continuar reconhecível.
Prepare o quadro inicial
Use uma imagem com sujeito e enquadramento claros, com espaço para o movimento. Revise texto, mãos e detalhes do produto antes de animar.
Separe sujeito e câmera
Uma pessoa virar para a câmera é diferente de a câmera orbitar uma pessoa parada. Comece com uma ação principal e avalie a preservação do sujeito.
Confira referências e quadros
Conforme o endpoint, o modelo pode aceitar quadro inicial, referências extras ou quadro final. Esses papéis são distintos e nem toda combinação é suportada.
Monte um pedido guiado por referência
Mantenha o ativo original ao lado de cada resultado para revisar a continuidade visual.
Escolha o ativo de origem
Use uma imagem que você está autorizado a processar e registre detalhes e composição a preservar.
Descreva o movimento
Defina uma ação e o comportamento da câmera; selecione duração e saída documentadas.
Inspecione a animação inteira
Revise início, meio e fim em busca de distorção e deriva, comparando o resultado com a imagem fonte.
Perguntas sobre API de Imagem para Vídeo
Esclareça as capacidades antes de integrar.
A imagem fornece ponto de partida ou referência visual, e o prompt orienta o movimento. Texto para Vídeo deixa mais da aparência inicial a cargo do modelo.